Non stiamo usando tutti la stessa intelligenza artificiale: il nuovo digital divide
Ci sono due criticità dell’intelligenza artificiale che considero importanti e su cui vorrei soffermarmi. Due questioni sulle quali avrebbe senso intervenire politicamente. Le ho incontrate nelle riflessioni di diversi esperti di intelligenza artificiale; tra quelli che ho seguito con maggiore interesse, ci sono gli interventi del programmatore italiano Salvatore Sanfilippo, conosciuto online come antirez, che vi consiglio di seguire.
La prima riguarda le differenze tra gli strumenti ai quali abbiamo accesso.
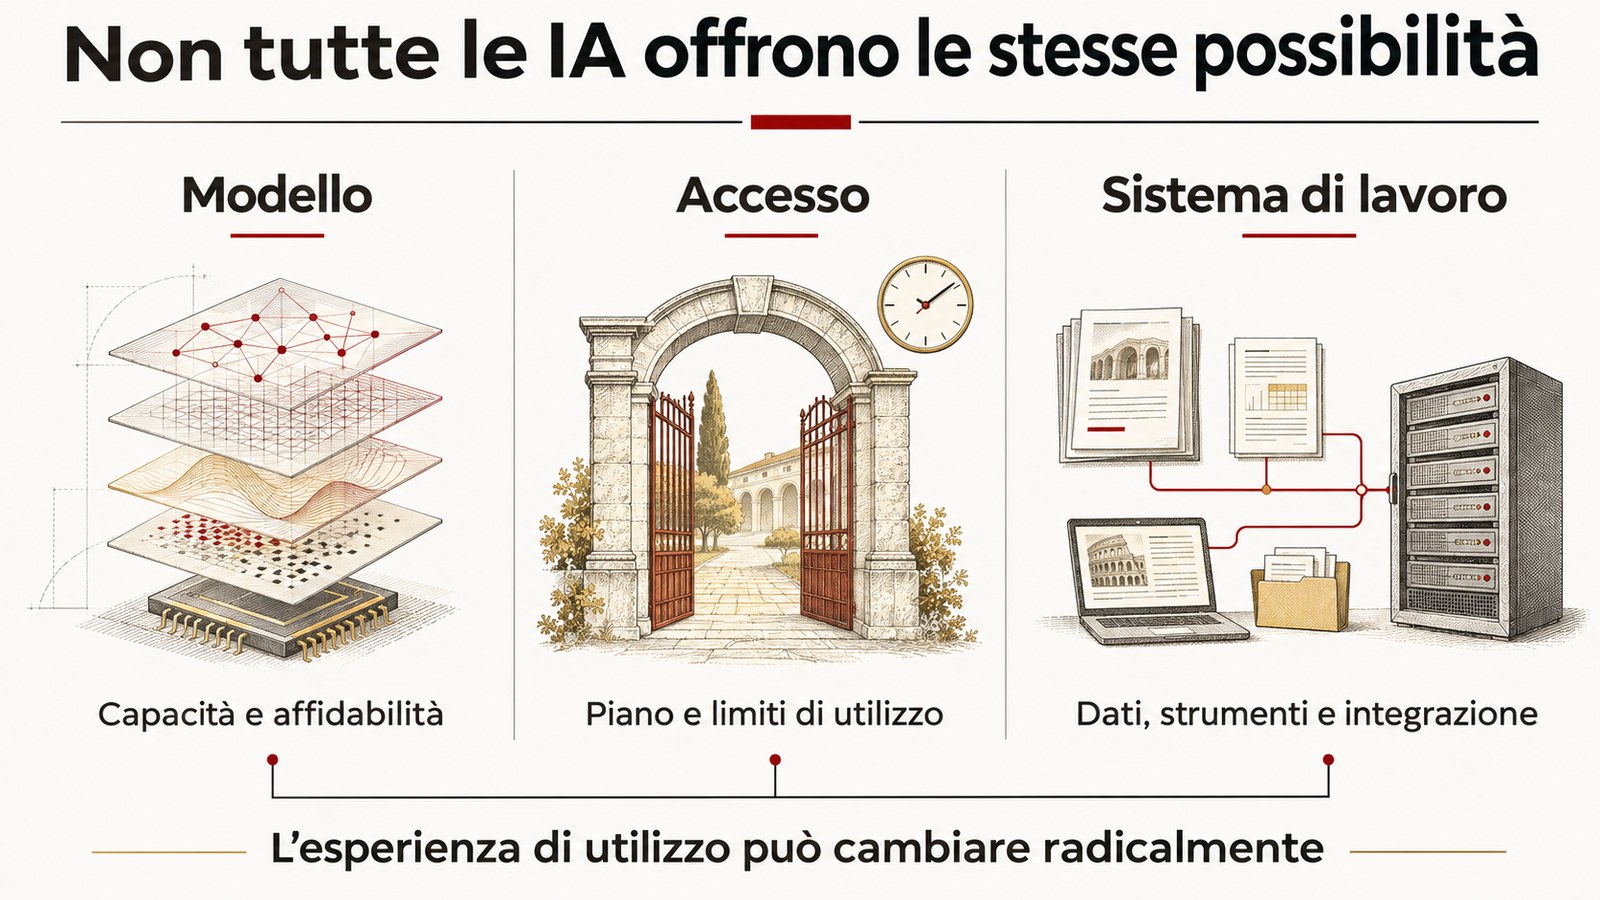
Parliamo abitualmente di “intelligenza artificiale” come se stessimo utilizzando tutti qualcosa di equivalente. Non è così. Le differenze, infatti, possono essere enormi, anche tra modelli dello stesso produttore. Inoltre, le capacità di un modello dipendono anche dall’ambiente in cui viene utilizzato e dagli strumenti che gli vengono messi a disposizione.
Un nuovo divario nell’accesso
Utilizzare un’intelligenza artificiale non significa avere accesso alle stesse possibilità di chi ne utilizza un’altra.
Me ne accorgo confrontando la mia esperienza con quella di persone che utilizzano occasionalmente le versioni gratuite, per esempio di Gemini, che è forse il più utilizzato tra i non professionisti. Web Crew utilizza le versioni a pagamento di due modelli di frontiera (Claude di Anthropic e ChatGPT di OpenAI) e abbiamo dedicato parecchio tempo a inserirle nel flusso di lavoro quotidiano. L’esperienza di utilizzo è completamente differente, quasi non paragonabile.
La differenza sta sicuramente nel fatto di utilizzare un piano a pagamento, ma contano anche quanto si pagano gli abbonamenti o i token (e quindi il modello effettivamente disponibile), i limiti di utilizzo e il modo in cui questi strumenti vengono inseriti nel proprio workflow lavorativo.
Questa situazione mi ricorda quello che agli albori di Internet veniva chiamato digital divide: il divario nelle possibilità di accesso e utilizzo delle tecnologie tra persone e contesti sociali differenti.
Parlare di intelligenza artificiale in generale, quindi, non ha molto senso. Bisogna capire a quali reali capacità possano avere accesso i singoli lavoratori. Siccome strumenti più efficaci permettono di migliorare notevolmente la propria produttività, la possibilità economica di utilizzarli può trasformarsi in un vantaggio professionale notevole.
La stessa differenza può ripresentarsi tra il singolo professionista e un’azienda che dispone di maggiori risorse. Quest’ultima può investire nell’integrazione dei modelli, nella preparazione dei dati e nella formazione delle persone, tutti investimenti indispensabili per far funzionare il sistema. Anche partendo da tecnologie disponibili al pubblico, e quindi teoricamente accessibili a tutti, le condizioni concrete di utilizzo possono essere molto diverse.
Il nuovo “digital divide”, quindi, non riguarda soltanto l’esistenza di modelli non disponibili al pubblico, ma già la differenza di accesso agli strumenti commercialmente disponibili a tutti.
Quando, nel dibattito pubblico, si parla di intelligenza artificiale, ci si riferisce in realtà a esperienze d’uso molto lontane tra loro.
Qualcuno, parlando di intelligenza artificiale, pensa magari a un assistente che utilizza quotidianamente, inserito in un sistema evoluto di lavoro. Qualcun altro invece pensa semplicemente alle risposte ottenute facendo ogni tanto una domanda a un chatbot gratuito.
Per questo, infatti, riesco a discutere più facilmente di questi temi con chi sta seguendo un percorso di utilizzo e apprendimento simile al mio. Pur non essendo un esperto di intelligenza artificiale, la sperimentazione continuativa mi ha portato a conoscere possibilità e difficoltà che nell’uso occasionale sicuramente non emergono.
Quando manca questa esperienza comune, prima ancora di confrontare le opinioni bisogna capire a che cosa ciascuno si riferisca quando dice “intelligenza artificiale”.
Il problema politico, quindi, riguarda sia l’accesso a strumenti efficaci sia le condizioni per imparare a utilizzarli. Rendere disponibile gratuitamente una chat non esaurisce in nessun modo la problematica.
Modelli aperti e potere delle piattaforme
La seconda questione riguarda chi controlla questi strumenti. Anche qui ritroviamo un problema che esisteva già nel web, ma con alcune differenze importanti.
Come è noto, alle origini del web c’è stata una grande scelta di apertura pubblica. Il 30 aprile 1993 il CERN mise nel pubblico dominio il software del World Wide Web sviluppato nel lavoro avviato da Tim Berners-Lee, una decisione di cui avevamo parlato anche nel nostro articolo sull’invenzione del web. Era una scelta che permetteva ad altri di utilizzare e sviluppare quella tecnologia senza dover chiedere il permesso a un proprietario.
L’idea di rendere disponibili strumenti e conoscenze ha avuto un ruolo importante nella storia della rete anche dopo la sua fondazione. WordPress, sul piano del software, e Wikipedia, su quello dei contenuti e della collaborazione, sono esempi differenti di questa possibilità.
Nel tempo, una parte crescente della nostra esperienza online si è però concentrata dentro servizi controllati da grandi aziende. Google, Facebook e Amazon, solo per fare alcuni esempi, hanno acquisito un peso enorme nell’accesso all’informazione, nella comunicazione e negli scambi commerciali. Sintetizzando, si potrebbe dire che “il capitale si è mangiato il web”.
L’intelligenza artificiale destinata al grande pubblico si sta sviluppando dentro un contesto già segnato da questa concentrazione. Ai protagonisti precedenti si sono aggiunti nuovi nomi, come OpenAI e Anthropic, ma il problema della dipendenza da pochi fornitori rimane.
La questione riguarda anche i dati. Per utilizzare un assistente nel lavoro occorre spesso fornirgli documenti, informazioni sull’organizzazione e dettagli sulle attività. Nell’uso personale possono entrare nella conversazione aspetti altrettanto riservati. Mi sembra probabile che, quanto più questi strumenti diventeranno utili, tanto più saremo portati a condividere informazioni con essi. Già oggi il livello di accesso del nostro assistente virtuale a documenti, materiali di lavoro e attività dell’agenzia è veramente rilevante.
Le condizioni di trattamento cambiano da un servizio all’altro. Ma il problema politico resta: quanta parte delle nostre attività vogliamo far dipendere da infrastrutture controllate da poche aziende estere?
Una possibilità per ridurre questa dipendenza esiste: utilizzare modelli scaricabili su un proprio computer o server. È quella che viene chiamata inferenza locale, cioè l’esecuzione del modello sulle proprie macchine. Se il sistema è interamente locale e non utilizza servizi esterni, i dati possono essere elaborati senza inviarli al fornitore del modello.
Si tratta di modelli open weight, dei quali vengono resi disponibili i pesi, cioè i parametri numerici appresi durante l’addestramento che determinano il modo in cui il modello elabora ciò che riceve e produce le risposte. Possiamo scaricarli ed eseguire il modello su macchine nostre, utilizzando un software compatibile e rispettando le condizioni della licenza.
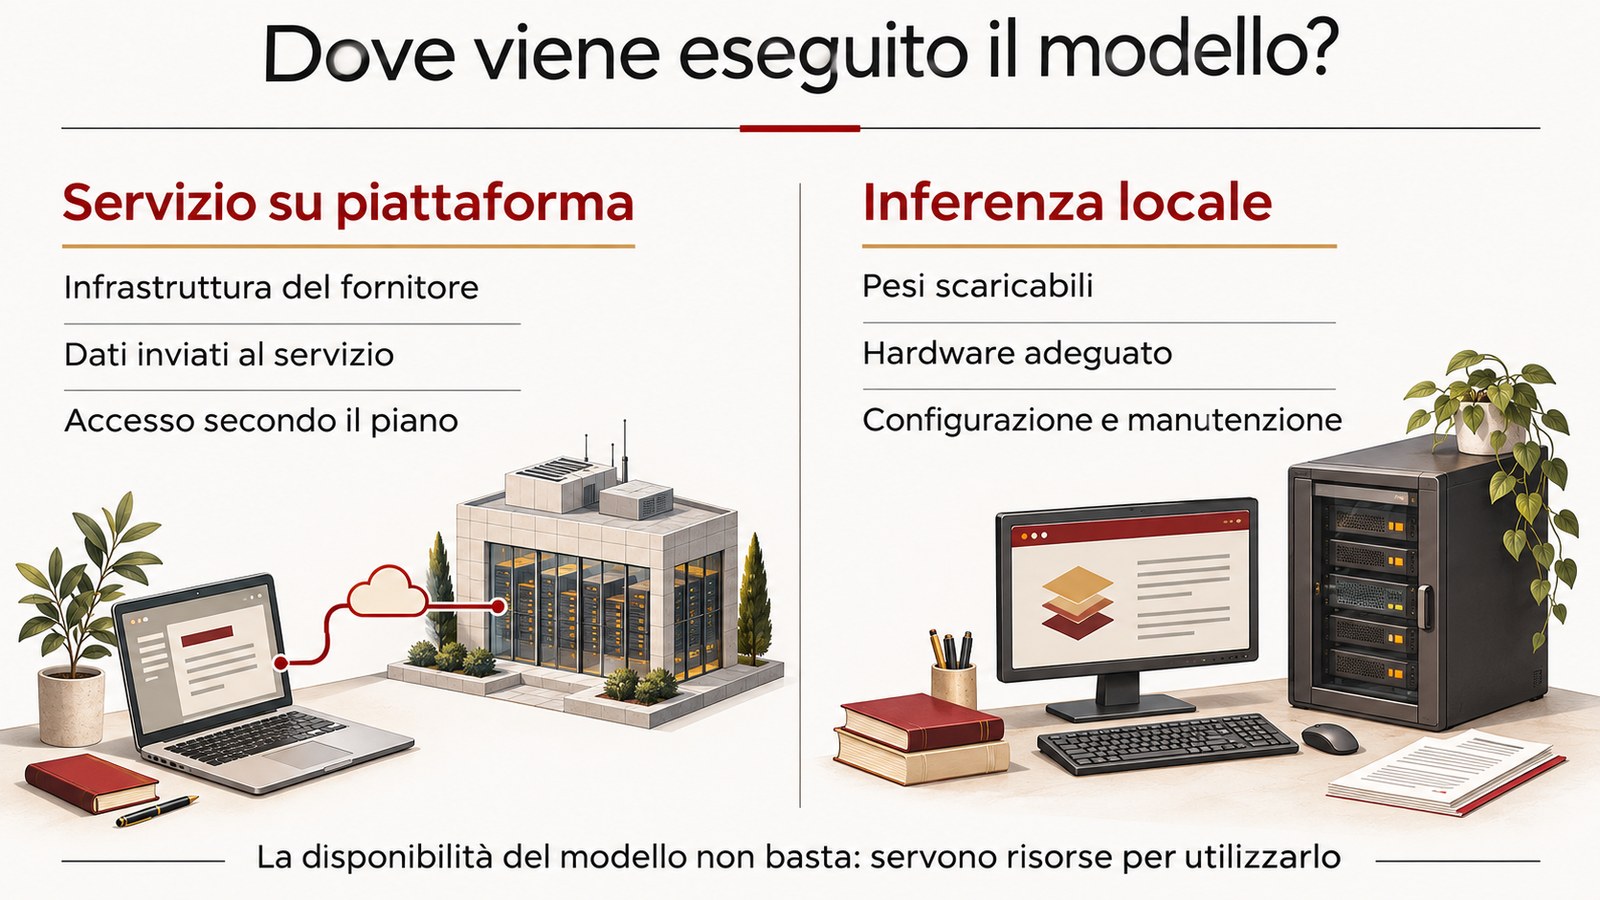
Il problema fondamentale dell’inferenza locale, al momento, riguarda l’hardware necessario per utilizzare i modelli più grandi e capaci. Servono quantità di memoria e capacità di calcolo che non sono affatto scontate su un normale computer, e procurarsi un sistema adeguato può richiedere un investimento importante. Contano poi anche la configurazione, la velocità con cui si vuole lavorare e le competenze necessarie a preparare il sistema.
Per il mio lavoro non ho ancora trovato una soluzione locale che mi permetta di sostituire con la stessa efficacia e praticità i servizi a pagamento che utilizzo. La disponibilità dei modelli è quindi una condizione importante, ma l’autonomia concreta può restare difficile da raggiungere per un singolo professionista o una piccola azienda.
Poter scaricare un modello e poterlo utilizzare efficacemente sono due condizioni diverse.
In questo ambito le aziende cinesi stanno avendo un ruolo particolarmente importante. DeepSeek e Alibaba, con la famiglia Qwen, sono fra i protagonisti della diffusione dei modelli aperti, e la pubblicazione dei pesi è una componente centrale della loro offerta. Mi sembra una differenza significativa rispetto alle principali aziende statunitensi, che concentrano gran parte della propria offerta di punta sui modelli chiusi, per quanto OpenAI abbia distribuito modelli open weight.
In Europa c’è poi il caso di Mistral, che pubblica modelli con pesi scaricabili e licenze aperte. Resta però centrale il contributo delle aziende cinesi, che stanno dando una spinta particolarmente forte alla disponibilità e alla diffusione di queste alternative.
La domanda, quindi, è come rendere questa possibilità abbastanza solida e accessibile da costituire un’alternativa reale alla dipendenza dalle piattaforme.
Mi sembra un terreno concreto per un intervento politico, anche europeo. Sostenere modelli aperti, infrastrutture accessibili e competenze diffuse potrebbe dare un contenuto pratico al discorso sull’autonomia tecnologica. Anche la possibilità di conservare dati e attività su sistemi controllati da chi li utilizza meriterebbe maggiore attenzione.
Le due questioni, insomma, si tengono insieme: chi può accedere agli strumenti più efficaci e quanto può utilizzarli senza dipendere interamente da un fornitore. È su problemi di questo tipo che vorrei vedere concentrarsi una parte maggiore del dibattito politico.