Non bloccare CCBot di Common Crawl
Devo essere sincero, i temi sollevati dal successo delle AI coinvolgono in modo molto profondo le logiche SEO a cui siamo stati abituati per anni, decenni.
Tali temi, pertanto, meriterebbero approfondimenti estensivi, che non possono però esaurirsi nelle poche righe di un blogpost, soprattutto se questo testo vuole rimanere abbastanza sintetico e fruibile per comunicare, in modo semplice, un’indicazione operativa per seo e webmaster.
La verità è che l’avvento delle AI è un’ottima opportunità per portare la professione SEO ad un livello di maturazione successivo, proprio perché inserisce nel settore dell’Information Retrival attori che non sono più, sic et simpliciter, limitati al solo caro vecchio Google.
Ma non voglio divagare, appunto, mio malgrado.
Il punto è che molti seo non vedono di buon occhio il crawling delle AI sui loro siti, per una serie di motivi.
La maggior parte pensa che i motori di risposta ad intelligenza artificiale siano responsabili della contrazione del traffico in ingresso sui siti proprietari. A buona ragione, se si vuole, ma occorre superare questo sentiment.
Altri, e stavolta con motivazioni pratiche forse più valide dei primi, perché il traffico bot consuma risorse server come non era mai stato prima, costringendo molti ad affrontare spese ulteriori, in termini infrastrutturali, per mantenere le performance ad un livello accettabile per il traffico umano.
Ma di nuovo, non volendo divagare troppo, queste preoccupazioni non verranno affrontate in questo articolo.
Il punto è che nel frattempo si parla di Generative Engine Optimization e sarà il caso di dare alcune indicazioni pratiche, rimandando le analisi teoriche più approfondite ad un altro momento.
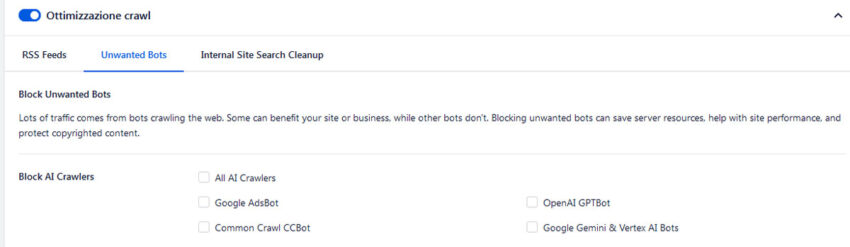
Con lo scopo di ottimizzare la presenza di un sito sui motori di risposta AI, suggerisco di non bloccare la scansione del proprio sito al bot usato da Common Crawl, CCBot.
L’ho voluto scrivere in modo molto esplicito perché ho notato che persino alcuni famosi plugin WordPress per la seo, come All-In-One SEO, offrono la possibilità di bloccare la scansione di CCBot, prorpio in omaggio alle preferenze che alcuni seo potrebbero avere in materia di scansione da parte dei bot AI, come accennate poco sopra.
Cos’è Common Crawl e come mai il suo bot non è inutile ai fini GEO?
Common Crawl è un’organizzazione no-profit nata nel 2008 con lo scopo di scansionare ed archiviare l’INTERO web per rendere poi disponibile il frutto di questa scansione massiva in archivi e datasets che siano pubblicamente consultabili.
Chi ricorda i claim del primissimo Google, quella di ‘archiviare l’intero web‘ era un’utopia digitale che aveva fatto di Google, appunto, il motore di ricerca per antonomasia per chi si è avventurato nelle lande sconfinate dello spazio digitale, fin dall’inizio e ancora oggi.
Ecco, ma se guardiamo almeno a due tra le figure chiave, ancora oggi, di Common Crawl, ci rendiamo conto che si tratta di persone che avevano fatto di quell’utopia qualcosa di tangibile, quasi concreto.
Il fondatore di Common Crawl è Gil Elbaz, che verso la fine degli anni ’90 aveva fondato Applied Semantics, la società che ha sviluppato quello che poi è diventato il primo algoritmo di Google Adsense. E infatti Elbaz è stato per anni capo ingegnere per Google, nella sede di Los Angeles.
Adsense, per chi se lo fosse scordato, si proponeva di leggere e valutare le pagine dei siti partecipanti al programma per offrire annunci testuali contestuali che fossero inerenti agli argomenti pubblicati sulle varie pagine dei publisher.
L’attuale Direttore esecutivo di Common Crawl è invece Rich Skentra. Imprenditore seriale, nonché fondatore di un motore di ricerca come Blekko, Skentra è noto, o dovrebbe esserlo, per aver fondato quello che all’epoca era noto come Open Directory Project. La Dmoz! LA directory a moderazione manuale operata da una comunità internazionale volontaria di utenti che si era occupata di ‘archiviare i siti web del mondo’ in categorie tematiche navigabili e consultabili.
Ebbene questi due soggetti, insieme ad uno staff di una ventina di persone non meno notabili, mantengono un progetto no-profit che ha archiviato oltre 250 miliardi di pagine web negli ultimi 15 anni, a cui aggiunge una media di 3-5 miliardi di nuove pagine ogni mese, tramite dump periodici.
Stiamo parlando di quasi 10 petabyte di dati, ora ospitati sui datacenter di Amazon AWS.
In che modo questa gigantesca collezione di dati copiati dalle pagine web di tutto il mondo rappresenta qualcosa da considerare se vogliamo ottimizzare la presenza del nostro sito sui motori AI?
L’asilo nido dei Large Language Models delle AI
Anche in questo caso il discorso potrebbe essere approfondito, sia dal punto di vista tecnico che da quello della narrazione storico-cronologica dei fatti.
Mi limiterò a dire che il dataset raccolto da Common Crawl con il CCBot è stato usato da diverse AI tra le più importanti per sviluppare la base dei LLM utilizzati dai motori di risposta generativa. Poco meno del 65% dei modelli di linguaggio di tutte le AI, secondo uno studio, sarebbe stato ‘allenato’ (“trained”) sul dataset di Common Crawl.
Sto parlando di OpenAI (ChatGPT), Anthropic (Claude), ma anche LLaMa di Meta e T5 di Google, da cui poi deriva Gemini.
Ovviamente le AI hanno poi sviluppato i loro propri bot, come GPTBot di ChatGPT per esempio, ma le risorse di scansione di Common Crawl rimangono una fonte preziosa per i motori AI, che naturalmente non possono – con la ovvia e sonora eccezione di Google, naturalmente – eguagliare l’expertise e l’infrastruttura di Common Crawl senza investire cifre enormi, cifre che come sappiamo sono oggi già ampiamente assorbite nell’acquisto di chipset per sostenere la potenza di calcolo e nel noleggio di datacenter in tutto il mondo.
Tralascio, anche qui in omaggio alla sintesi, le polemiche che sono nate quando si è scoperto, ancora di recente nel novembre 2025, che CCBot fingeva di seguire le indicazioni dei file robots.txt, ma in realtà andando a fare scraping anche dei contenuti editoriali coperti da paywall, o inibiti alla scansione da alcune fonti che volevano evitare di fornire alle AI i propri contenuti.
Il fenomeno del web scraping e il data collection massivo sono naturalmente temi sensibili, non solo per i seo ma in generale per chiunque produca contenuti in ambiente digitale.
Ma ciò che si voleva affermare è che una politica di totale apertura al crawling, che purtroppo si traduce anche in un aumento delle risorse server necessarie per assicurare le performance di navigazione utente che sono oggi indispensabili per offrire al pubblico siti veloci ed accessibili, costituisce una base di partenza preziosa per ottimizzare i propri contenuti all’indicizzazione da parte dei motori di risposta AI based.
Proprio come era per la scansione da parte di Google, che è stato per decenni il più grande ed importante web scraper del mondo, anche per i bot AI la speranza è che gli editori di contenuti possano ottenere, in cambio dei propri contenuti, un ritorno di visibilità e – anche, in qualche misura ancora tutta da verificare – traffico web da parte dei motori AI.
Naturalmente la Generative Engine Optimization, non poteva essere altrimenti, parte dalla capacità di rendersi appetibili alla scansione da parte di bot.
Robot AI, ma pur sempre bot. Di cui CCBot è il capostipite, appunto, il bot che ha raccolto il corpus di contenuti più strepitosamente enorme su cui tutti i principali bot AI hanno imparato a formare i loro modelli di risposta, e che ancora ogni mese rende disponibile, gratuitamente, un aggiornamento che coinvolge miliardi di pagine web.